Chegou o Opus 4.7. E ele pensa mais do que você pede
A atualização mais forte da Anthropic mudou o modelo. E mudou como você precisa falar com ele.
Apr 16, 2026 · 4 min read
Durante dois anos, a gente aprendeu a conversar com IA de código como se fosse um pair programmer. Linha por linha. Pergunta curta, resposta curta. Corrige, segue, corrige de novo.
O Opus 4.7 quebra esse hábito.
A Anthropic foi direta: pare de tratar o modelo como pair e comece a tratá-lo como um engenheiro capaz para quem você está delegando. Essa mudança não é marketing. É a diferença entre extrair o melhor do modelo ou torrar tokens em conversinha.
O que mudou na prática
O 4.7 pensa mais entre as rodadas. Principalmente em sessões longas. Isso melhora coerência, qualidade de código e aderência à instrução, mas também significa que cada turno extra de usuário adiciona custo de raciocínio.
Traduzindo: quanto mais você interrompe, mais caro e mais lento fica. Quanto melhor a primeira instrução, mais o modelo entrega sozinho.
A receita da Anthropic é clara:
Especifique a tarefa na primeira rodada. Intenção, restrições, critérios de aceite, onde estão os arquivos relevantes. Tudo de cara.
Reduza o número de interações necessárias. Agrupe suas dúvidas. Dê contexto suficiente pro modelo seguir sozinho.
Use o auto mode quando fizer sentido. Ele já está em research preview para usuários do Claude Code Max. Shift+Tab ativa.
Essa é a parte que custa. Não porque é difícil. Porque contraria o hábito.
O novo nível de esforço: xhigh
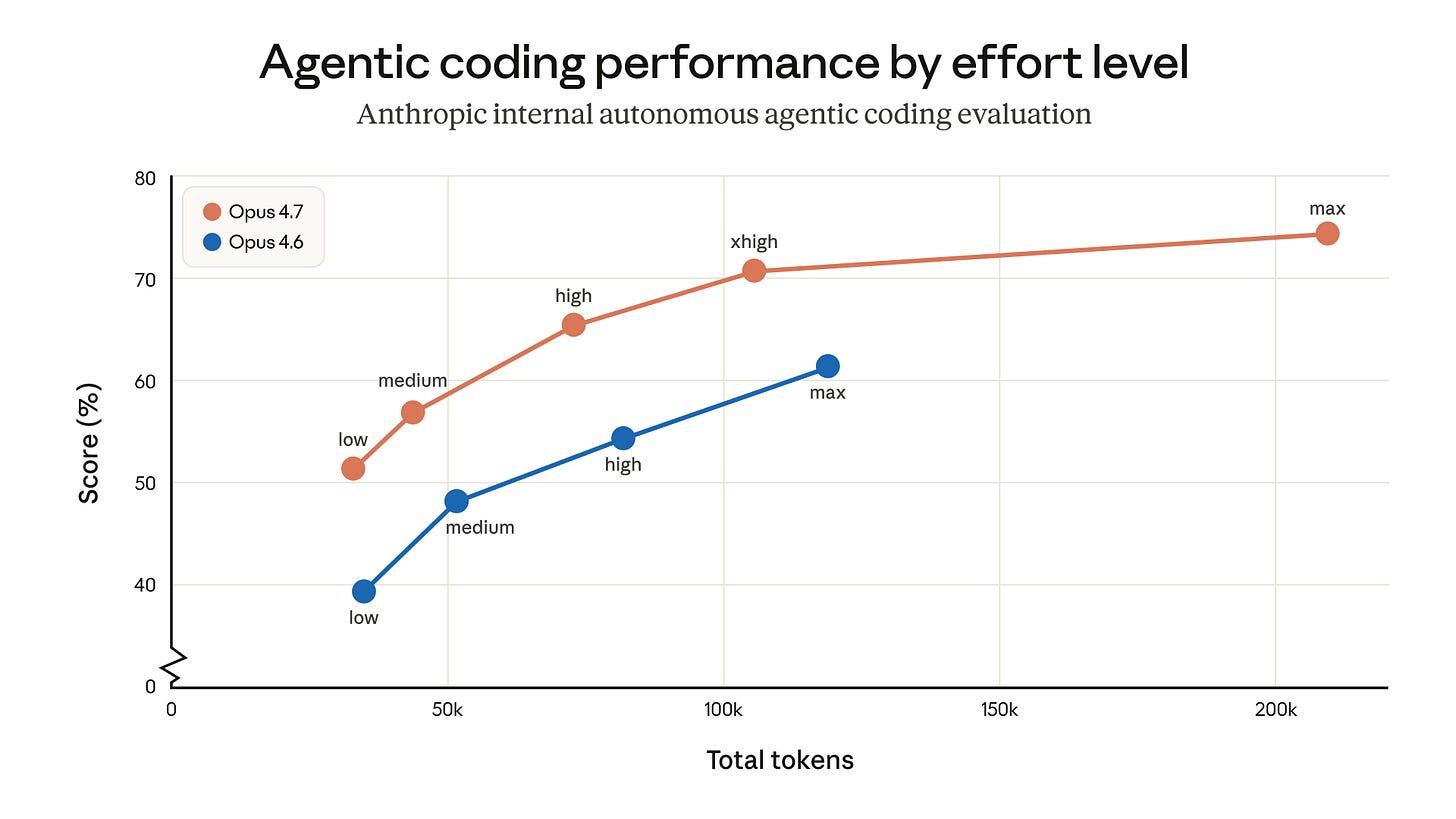
O padrão mudou. Não é mais high, não é max. É xhigh, um nível novo entre os dois. E agora é o default para usuários do Claude Code.
A lógica é simples: max tende a pensar demais em tarefas longas e estoura tokens sem ganho proporcional. High economiza mas deixa performance na mesa em tarefas complexas. Xhigh fica no ponto doce, autonomia e inteligência sem descontrole.
A recomendação da Anthropic é direta: mantenha em xhigh e veja até onde o primeiro turno te leva.
Isso importa porque muita gente vai subir para max achando que é sempre melhor. Não é. Max é pra casos cirúrgicos, teste de teto, problema genuinamente difícil e sem restrição de custo. Pra trabalho agentic do dia a dia, xhigh ganha.
Adaptive thinking (e o fim do thinking budget fixo)
Extended Thinking com budget fixo não é mais suportado no 4.7.
Agora é adaptive thinking. O modelo decide quanto pensar baseado no contexto. Pergunta boba responde rápido. Passo que não se beneficia de raciocínio ele pula. Investe os tokens onde realmente é relevante
E aqui está o ponto que muita gente vai ignorar, porém é super relevante… Se você quer controlar, você prompta.
Quer mais thinking? “Pense com cuidado, passo a passo. Esse problema é mais difícil do que parece.”
Quer menos? “Priorize responder rápido em vez de pensar profundamente. Na dúvida, responda direto.”
O controle deixou de ser configuração. Virou instrução.
Mudanças de comportamento que vão pegar gente desprevenido
Se você tem prompt tunado pro 4.6, três coisas vão te surpreender.
Respostas mais calibradas ao tamanho da tarefa. O 4.7 é menos verboso por padrão. Lookup simples vem curto, análise aberta vem longa. Se você depende de um formato específico, estabeleça isso no prompt. Exemplos do que você quer funcionam melhor que proibições do que não quer.
Menos tool calls, mais reasoning. O modelo escolhe pensar antes de agir. Na maioria dos casos, melhora resultado. Mas se você precisa de mais agressividade em busca ou leitura de arquivos, escreva exatamente quando e por quê usar a ferramenta.
Menos subagents por padrão. O 4.7 é mais criterioso em delegar. Se seu caso de uso ganha com paralelismo, por exemplo varrer múltiplos arquivos ao mesmo tempo, você precisa explicitar: “não crie subagent pra trabalho que dá pra fazer direto, crie múltiplos no mesmo turno quando for distribuir trabalho entre itens.”
Nada disso é bug. É calibração. Mas prompt tunado no 4.6 vai precisar revisão.
O que realmente está acontecendo aqui
Modelo mais inteligente não significa que a sua forma de usar continua boa.
O 4.7 foi otimizado pra tarefas longas onde supervisão era gargalo. Mudanças complexas em múltiplos arquivos, debugging ambíguo, code review em serviço inteiro, trabalho agentic de vários passos. É nessas situações que ele brilha.
E o custo de operar ele bem é você abrir mão da ilusão de controle turno a turno. Quem continuar no modelo pair vai achar que o 4.7 “gasta mais token” e “responde menos”. Quem adotar o modelo delegação vai ver o oposto: mais conclusão, menos intervenção, melhor output.
A matemática é simples. Primeiro turno bem especificado vence dez turnos de vai e volta.
O que fazer ainda hoje
Se você usa Claude Code, não faz nada. Você já foi migrado para xhigh automaticamente.
Se você tinha prompt tunado no 4.6, revisa. Principalmente os que dependiam da verbosidade padrão, de tool calls agressivos, ou de subagents automáticos.
Se você nunca testou auto mode, é hora. Shift+Tab no Claude Code Max.
E se você ainda não leu o artigo original da Anthropic, leia. É curto, é direto, e tem detalhe que não coube aqui.
O ajuste não é no modelo. É em você. Link do artigo original: https://claude.com/blog/best-practices-for-using-claude-opus-4-7-with-claude-code