Google lançou um agente que joga qualquer jogo 3D e se aprimora sozinho
O Google DeepMind acabou de revelar o SIMA 2, e isso não é mais um agente de IA que segue comandos dentro de um jogo específico.
Nov 13, 2025 · 4 min read
O Google DeepMind acabou de revelar o SIMA 2, e isso não é mais um agente de IA que segue comandos dentro de um jogo específico. Estamos falando de um sistema que entra em mundos virtuais completamente novos, entende contexto, raciocina sobre objetivos e melhora através de tentativa e erro.
Sem precisar ver código. Sem precisar de treinamento prévio naquele ambiente.
A evolução do SIMA 1 para o SIMA 2 expõe algo que você deveria estar observando: a diferença entre seguir instruções e realmente entender o que fazer.
Do decoreba para raciocínio
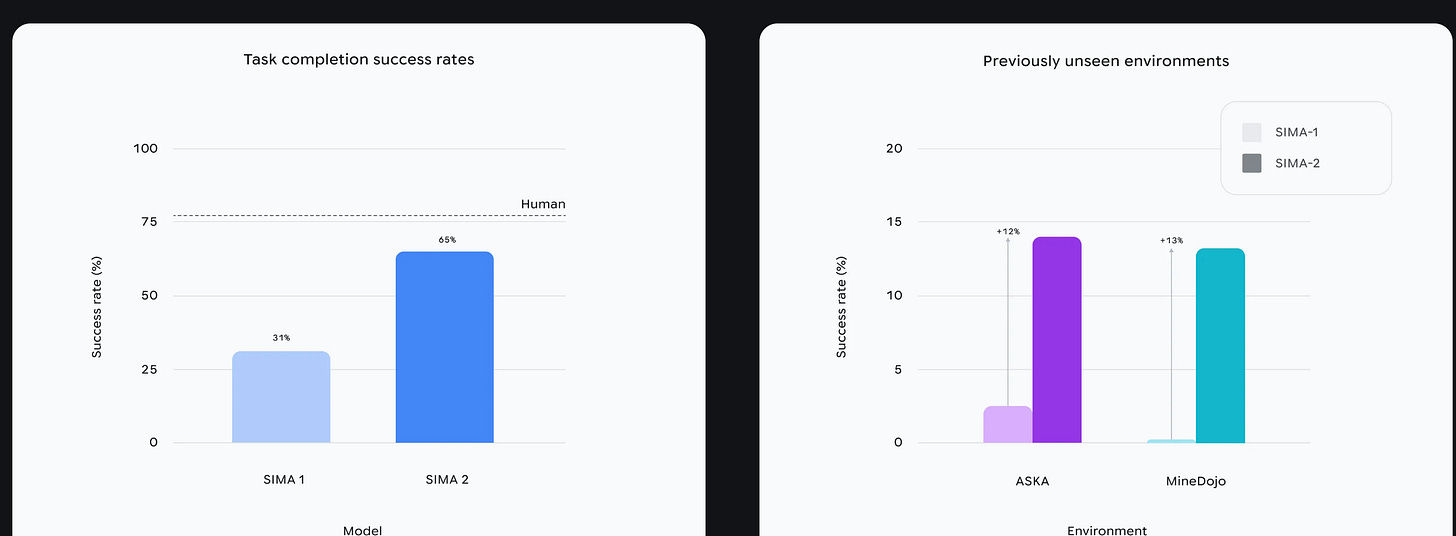
SIMA 1 tinha 31% de taxa de sucesso em tarefas complexas. Humanos tinham 71%.
SIMA 2 quase dobrou essa performance ao integrar o Gemini 2.5 Flash Lite. A jogada aqui não foi mais dados de gameplay humano. Foi capacidade de raciocínio.
Você manda ele cortar uma árvore com emojis (machado + árvore), e ele vai lá e corta. Você diz para ir até “a casa que parece um tomate maduro”, e ele entende que você está falando de uma casa vermelha. Isso não é correspondência mecânica de padrões, é interpretação semântica.
O agente não está decorando movimentos. Ele está construindo um modelo mental do ambiente, dos objetos, das affordances possíveis.
Testaram ele dentro de mundos gerados pelo Genie 3 que nunca tinha visto antes e ele simplesmente se orientou, identificou objetos (bancos, árvores, borboletas) e executou instruções.
Self-improvement sem humano no loop
Aqui é onde fica interessante para quem constrói produtos.
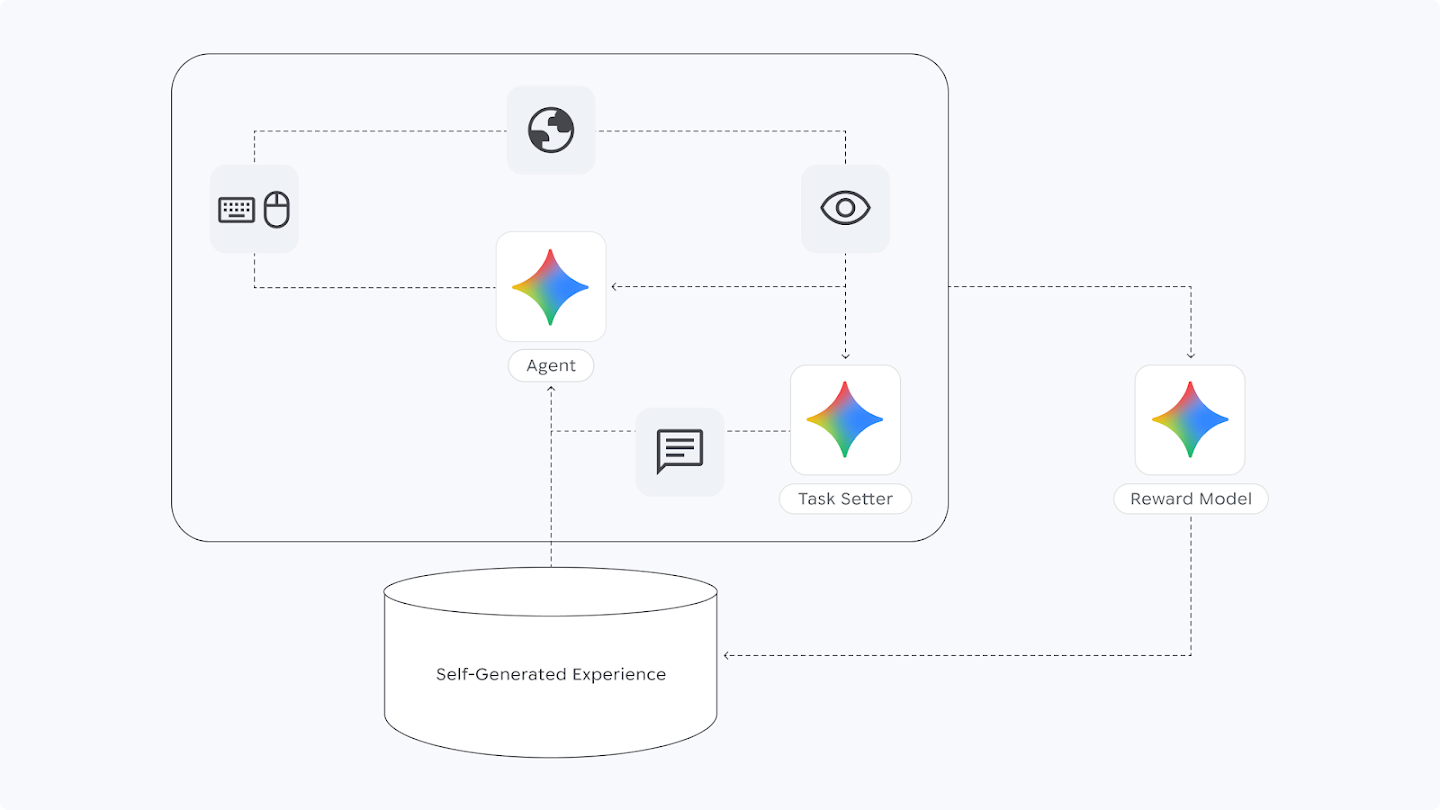
O SIMA 1 dependia de centenas de horas de gameplay humano. O SIMA 2 usa isso apenas como baseline inicial.
Depois disso: um modelo Gemini gera novas tarefas, outro modelo de recompensa avalia as tentativas, e o agente aprende com seus próprios erros através de reinforcement learning from AI feedback.
Sem custo de anotação humana. Sem limite de escala baseado em disponibilidade de experts jogando.
O agente entra num ambiente novo, recebe tarefas geradas automaticamente, tenta, falha, registra a experiência, retreina. Loop contínuo.
O que isso significa para robótica
Você pode estar pensando: legal, mas é só videogame.
DeepMind está explicitamente posicionando isso como caminho para robótica física.
A arquitetura separa cognição de alto nível (entender tarefas, raciocinar sobre objetos, planejar) da execução motora de baixo nível (torque de juntas, controle preciso).
Mundos virtuais 3D são sandbox perfeitos para treinar a camada de raciocínio sem arriscar hardware caro ou segurança física. Depois você transfere para o mundo real.
O gap sim-to-real ainda existe. Casas reais são mais bagunçadas que jogos, iluminação varia, oclusão acontece, objetos se desgastam.
Mas se um agente consegue consistentemente interpretar “conte quantas latas de feijão tem no armário” em simulação e realmente encontrar latas, armários, entender contagem, você está reduzindo a distância entre conceito e execução.
Generalização cross-domain
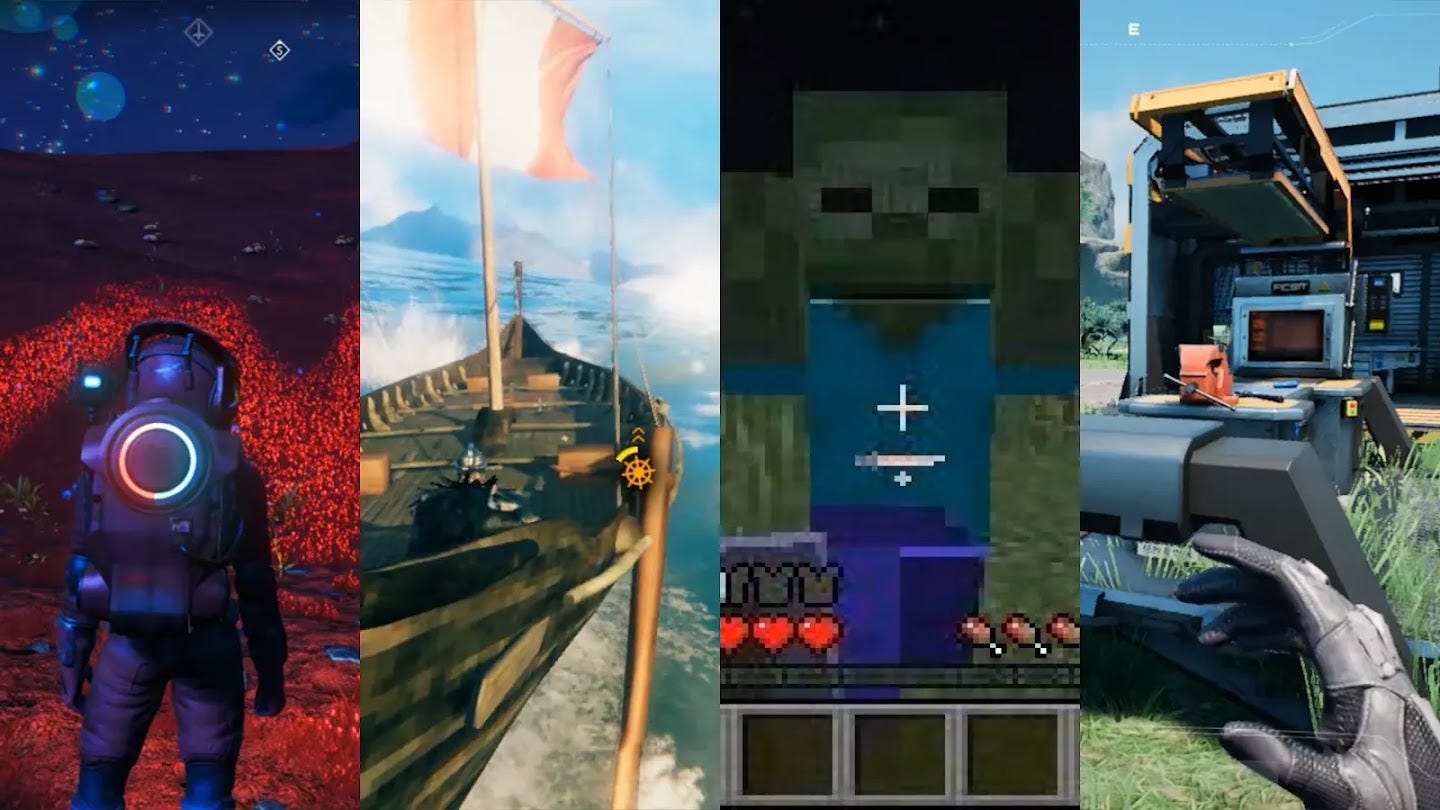
SIMA 2 foi treinado em oito jogos comerciais (No Man’s Sky, Goat Simulator 3, Valheim, Satisfactory, Space Engineers, Teardown, entre outros) e três ambientes virtuais próprios.
Quando testaram ele em MineDojo (um clone de Minecraft que nunca viu no treinamento), ele simplesmente executou tarefas que o SIMA 1 falharia.
A métrica não é mais “quão bem você joga Counter Strike” ou “quão bem você resolve xadrez”. É “quão bem você se adapta a qualquer ambiente interativo que te jogarem”.
Isso é o sinal de que a competência está se tornando horizontal, não vertical.
As limitações que importam
DeepMind foi transparente sobre o que ainda não funciona.
Tarefas de horizonte muito longo que exigem raciocínio multi-step extensivo e verificação de objetivos ainda são desafio. A memória do agente é limitada por janela de contexto para manter latência baixa. Execução precisa via teclado e mouse e compreensão visual robusta de cenas 3D complexas continuam sendo problemas em aberto.
Não é AGI. É um passo significativo em direção a agentes generalistas que unificam capacidades de múltiplos sistemas especializados.
O que você deveria estar extraindo disso
Primeiro: a era dos agentes que apenas seguem scripts acabou. O novo padrão é raciocínio contextual e auto-melhoria.
Segundo: self-supervised learning com feedback de IA vai escalar muito mais rápido que qualquer pipeline dependente de anotação humana.
Terceiro: se você está construindo produtos que dependem de agentes interagindo com ambientes (sejam virtuais ou físicos), a camada de cognição de alto nível vai se commoditizar. Sua vantagem competitiva estará na execução específica do domínio e na qualidade dos seus loops de feedback.
Quarto: mundos sintéticos não são mais apenas para treinar modelos de visão computacional. São ambientes de treinamento completos para comportamento agêntico complexo.
O Google não lançou isso como produto. É research preview. Mas a direção está clara.
Agentes que aprendem qualquer tarefa em qualquer ambiente sem precisar de milhões de exemplos humanos não estão a dez anos de distância. Estão aqui, em versão beta, rodando em jogos comerciais hoje.
A pergunta que você deveria estar fazendo não é “quando isso vai estar pronto”, mas sim “o que eu vou construir assumindo que isso já funciona”.